Domain dsqu.de kaufen?
Wir ziehen mit dem Projekt
dsqu.de um.
Sind Sie am Kauf der Domain
dsqu.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dsqu.de kaufen?
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
Ähnliche Suchbegriffe für Individuellere Betreuung
Top-Angebote
Produkte zum Begriff Individuellere Betreuung:
-
Smoke Factory Data II 2,6KW Fog MachineSmoke Factory Data II 2,6KW Fog Machine, Data II 2,6KW Fog Machine. Die neue Generation der "klassischen" Power- Nebelmaschinen. Digitale Powernebelmaschine mit zwei Pumpen. 230 V/ 2600 W. Externer Ausgang für optionalen Lüfter für max. 800 W, extrem starker Nebelausstoß, Mengenre - gulierung zwischen 1 % und 99 %. DMX, Timer und Schlauchblende serienmäßig. Dauer - nebel bei reduziertem Ausstoß. Achtung: Bitte verwenden Sie nur das original Smoke Factory Fluid. Andere Fluide führen zum Verstopfen des Gerätes und ein GARANTIE Anspruch erlischt in diesem Fall!1225,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Wie kann man Körperdaten sinnvoll nutzen, um die Gesundheit zu verbessern und individuellere Behandlungen zu ermöglichen?
Durch regelmäßige Messung und Analyse von Körperdaten wie Blutdruck, Herzfrequenz und Aktivitätslevel können Gesundheitstrends erkannt und präventive Maßnahmen ergriffen werden. Diese Daten können auch Ärzten helfen, individuellere Behandlungspläne zu erstellen, die besser auf die Bedürfnisse des Patienten zugeschnitten sind. Durch die Integration von Körperdaten in Gesundheits-Apps und Wearables können Menschen auch selbstständig ihre Gesundheit überwachen und verbessern. **

Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
Top-Angebote
Produkte zum Begriff Individuellere Betreuung:
-
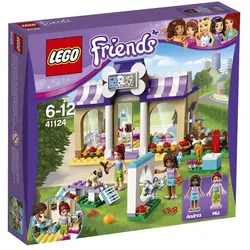
LEGO® Friends 41124 Heartlake Welpen-BetreuungAlle Hunde in Heartlake City lieben es, zum Spielen in die Heartlake Welpen-Betreuung von Andrea und Mia zu kommen. Lauf mit ihnen durch den Geschicklichkeitsparcours im Garten – das ist wie ein Spielplatz für Hündchen! Geh nach drinnen, um den Husky Luna und den Mops Toffee gründlich zu waschen und den beiden das Fell zu bürsten. Anschließend können sie ein wenig Futter bekommen und sich auf ihren speziellen Betten ausruhen, während du eine neue Buchung am Computer annimmst. - Enthält die Spielfiguren Andrea und Mia sowie einen Husky und einen Mops. - Enthält die Heartlake Welpen-Betreuung. In dem Gebäude gibt es eine aufklappbare Tür, ein Bad, eine Fellpflegestation, Hundebetten, einen Bereich zum Füttern der Hunde, einen Bürobereich sowie eine Hundeklappe zum Garten. - Im Garten befinden sich der Geschicklichkeitsparcours mit 2 Hindernissen sowie ein drehendes Karussell, ein Podest und ein Trinkbrunnen. - Als Zubehör sind ein Computer, ein Telefon, eine Wurzelbürste, Hundeshampoo, Haarschleifen, Hundekuchen, Knochen, ein Hydrant, eine Schaufel, ein Eimer, ein Ball, ein Stock und ein Pokal enthalten. - Setz die Hunde vor den Spiegel und verwende die Bürste, das Shampoo und die Haarschleifen, um sie richtig hübsch zu machen. - Benutze den Computer und das Telefon in der Welpen-Betreuung, um neue Buchungen entgegenzunehmen und mit Kunden zu sprechen. - Fahre mit den Hündchen Karussell und hilf ihnen über die Hindernisse im Geschicklichkeitsparcours, um siezu trainieren. - Dieses Set bietet Kindern im Alter von 6 bis 12 Jahren ein altersgerechtes Bauerlebnis. - Die Heartlake Welpen-Betreuung ist 9 cm hoch, 19 cm breit und 12 cm tief.120,00 €*Versand: 7,70 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Was sind die grundlegenden Konzepte und Anwendungen von Regression in Statistik und Machine Learning?
Regression in Statistik und Machine Learning befasst sich mit der Vorhersage von kontinuierlichen Werten basierend auf anderen Variablen. Die grundlegenden Konzepte umfassen die Bestimmung einer mathematischen Beziehung zwischen den Variablen, die Schätzung von Parametern und die Bewertung der Modellgenauigkeit. Anwendungen von Regression sind vielfältig, wie z.B. die Vorhersage von Aktienkursen, Wetterprognosen oder medizinische Diagnosen. **
Ähnliche Suchbegriffe für Individuellere Betreuung
-
Smoke Factory Data II 2,6KW Fog MachineSmoke Factory Data II 2,6KW Fog Machine, Data II 2,6KW Fog Machine. Die neue Generation der "klassischen" Power- Nebelmaschinen. Digitale Powernebelmaschine mit zwei Pumpen. 230 V/ 2600 W. Externer Ausgang für optionalen Lüfter für max. 800 W, extrem starker Nebelausstoß, Mengenre - gulierung zwischen 1 % und 99 %. DMX, Timer und Schlauchblende serienmäßig. Dauer - nebel bei reduziertem Ausstoß. Achtung: Bitte verwenden Sie nur das original Smoke Factory Fluid. Andere Fluide führen zum Verstopfen des Gerätes und ein GARANTIE Anspruch erlischt in diesem Fall!1225,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wendougee DATA-S Dual Boiler Espresso Machine · White/SilverPrecision for your Taste. With the Wendougee DATA-S, you precisely control pressure and flow via a gear pump. Save your brewing profiles in the E-Bar app. The saturated brew group and PID control ensure a constant temperature. Two boilers and the choice between tank and direct water connection make this espresso machine the centerpiece of your coffee station. Gear pump with pressure profiling and flow-priority mode 0.8-liter brew boiler and 1.8-liter steam boiler 1.5-liter water tank or direct water connection Stainless steel casing, steam wand, and hot water spout Tablet optional, not included in standard delivery.3499,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die grundlegenden Konzepte und Anwendungen der Regression in Statistik und Machine Learning?
Die Regression ist eine statistische Methode, um die Beziehung zwischen einer abhängigen und einer oder mehreren unabhängigen Variablen zu modellieren. Sie wird verwendet, um Vorhersagen über zukünftige Werte der abhängigen Variablen zu treffen. In Machine Learning wird Regression häufig verwendet, um kontinuierliche Werte vorherzusagen, wie z.B. Verkaufsprognosen oder Immobilienpreise. **
-
Wie kann man Körperdaten sinnvoll nutzen, um die Gesundheit zu verbessern und individuellere Behandlungen zu ermöglichen?
Durch regelmäßige Messung und Analyse von Körperdaten wie Blutdruck, Herzfrequenz und Aktivitätslevel können Gesundheitstrends erkannt und präventive Maßnahmen ergriffen werden. Diese Daten können auch Ärzten helfen, individuellere Behandlungspläne zu erstellen, die besser auf die Bedürfnisse des Patienten zugeschnitten sind. Durch die Integration von Körperdaten in Gesundheits-Apps und Wearables können Menschen auch selbstständig ihre Gesundheit überwachen und verbessern. **
-
Warum Deep Learning im Vergleich zu Machine Learning?
Deep Learning unterscheidet sich von Machine Learning durch seine Fähigkeit, automatisch Merkmale aus den Daten zu extrahieren, anstatt dass diese manuell definiert werden müssen. Dadurch ist Deep Learning in der Lage, komplexere und abstraktere Muster in den Daten zu erkennen und zu lernen. Dies ermöglicht es Deep Learning-Modellen, in vielen Anwendungsbereichen, wie Bild- und Spracherkennung, bessere Leistungen zu erzielen als herkömmliche Machine Learning-Modelle. **
-
Was ist Python Machine Learning?
Python Machine Learning bezieht sich auf die Verwendung von Python-Programmierung, um maschinelles Lernen zu implementieren. Dabei werden Algorithmen und Modelle erstellt, die es Computern ermöglichen, aus Daten zu lernen und Vorhersagen zu treffen. Python bietet eine Vielzahl von Bibliotheken wie Scikit-learn, TensorFlow und Keras, die das Entwickeln von Machine-Learning-Anwendungen erleichtern. Mit Python Machine Learning können komplexe Probleme gelöst und Muster in großen Datenmengen entdeckt werden. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.